Visualizzazione post con etichetta interview question. Mostra tutti i post

domenica 19 agosto 2012

Thread...che passione!

Oggi parliamo di questi benedetti Thread e di come si implementano in Java. Per prima cosa vediamo la definizione data da Wikipedia: "un thread o thread di esecuzione è una suddivisione di un processo in due o più filoni, che vengono eseguiti concorrentemente dal processore". In sostanza il thread non è altro che un pezzo di processo. Come si implementa il multi-threading  in Java? ossia come gestire più thread in Java? Esistono due vie, tecnicamente entrambe valide, per implementare il multi-threading e cioè attraverso l'implementazione dell'interfaccia  Runnable o creando una classe che estenda la classe Thread.
Nel primo caso scriviamo una nuova classe che implementi l'interfaccia Runnable e assegniamo un istanza di questa classe ad un nuovo oggetto Thread. Ecco un esempio:

public class SayHello implements Runnable {
private String greeting;

public SayHello(String greeting) {
  this.greeting = greeting;
}

public void run() {
 for(int i = 1; i < = 10; i++) {
 System.out.print(greeting);
 }
 System.out.println(“End of run”);
 }
}

è necessario implementare il metodo run in cui inseriremo il codice che dovrà essere eseguito dal Thread. Tutto questo però non rende un oggetto di classe SayHello un oggetto Thread. Occorre associare l'istanza della classe Say Hello con un nuovo oggetto Thread:

public class CountToTen {
public static void main(String [] args) {
   SayHello hello = new SayHello(“Hi”);
   Thread t = new Thread(hello);
   t.start();
   for(int k = 1; k < = 10; k++) {
       System.out.print(k);
   }
   System.out.println(“End of main”);
  }
}

Nel secondo caso creiamo una nuova classe che estende la classe Thread e in cui sovrascriviamo il metodo run:


public class MyThread extends Thread {
 private String message;
 private boolean keepGoing;

 public MyThread(String m) {
   message = m;
   keepGoing = true;
 }

 public void setKeepGoing(boolean b) {
   keepGoing = b;
 }

 public void run() {
     while(keepGoing) {
         System.out.print(message + “ “);
         try {
                Thread.sleep(1000);
         }catch(InterruptedException e) {}
    }
    System.out.println(“gone!”);
 }
}


Ora non sarà più necessario istanziare due oggetti come avveniva con il precedente pezzo di codice:


public class Main {
 public static void main(String [] args) {
    MyThread myThread = new MyThread(“going”);
    myThread.start();
    try {
           Thread.sleep(6000);
     }catch(InterruptedException e) {}
 myThread.setKeepGoing(false);
 System.out.println(“End of main”);
 } 
}

Ma quale dei due metodi conviene usare? Da un punto di vista object-oriented, l'opzione da preferire per scrivere un thread è implementare Runnable. Infatti cosi facendo si crea una giusta separazione tra l'oggetto thread (che sarà schedulato, sincronizzato ecc.) e l'oggetto runnable che contiene il codice eseguito quando il thread è schedulato.

domenica 8 luglio 2012

Question and answer: pre-intervew

Ma come si svolge un colloquio a Londra presso un azienda informatica? Il processo completo lo spiegherò in dettaglio in un post successivo ma in questo vi fornisco un piccolo suggerimento. L'azienda appena approccia un potenziale candidato, effettua un primo test ponendo diversi quesiti. Questi servono a capire se il candidato ha le basi e se può partecipare ad una interview face to face.Ad esempio per un ruolo come java developer le domande potrebbero essere queste:


1)      What blogs, publications, and websites do regularly you use to keep up to date with the latest technologies? Do you actively contribute to any of them?


2)      In the following example, which features of the Java language are illustrated in (a) methodOne’s parameter list, and (b) the ‘for’ loop?
   class MyNewClass {
       public static void methodOne(String s, String t, Integer ... ii) {
              for(int jj : ii) {
                     System.out.print(jj + " " + s + " " + t);
              }
       }
   }


     3)      Our clients operate in a global market, therefore our applications must operate in many different countries.  Name two basic data types whose format varies between countries, that software must account for.
      4)      Simplify the following section of code.
   public void showCollection (Collection collection) {
         Iterator ii = collection.iterator();
         for(int kk = 0; kk < collection.size(); kk++) {
                 MyClass one = (MyClass) ii.next();
                 one.printResult();
         }
   }


      5)      What feature of the Java programming language is the following code an example of? If you’ve used the feature to solve a problem, please give an example.
   Class c = Class.forName("java.lang.String");
   Method m[] = c.getDeclaredMethods();
     6)      What type of design pattern is this? Can you name one or more potential issues with this pattern?
   public class MyObject {
       private static final MyObject INSTANCE = new MyObject();
private MyObject () {}
public static MyObject getInstance() {
return INSTANCE;
   }
   }


    Sei pronto per questo tipo di domande?

sabato 30 giugno 2012

Volatile: cosa vuol dire in Java?

Spesso accade durante una interview che venga chiesto cosa sia e cosa voglia dire la keyword "volatile" in Java. Questa parola è usata per indicare ad un Thread di non memorizzare il valore di una variabile nella cache ma direttamente nella memoria principale. Perché? Ora immaginiamo che il Thread A modifichi il valore della variabile "pippo". Se il Thread B deve leggere il valore di tale variabile potrebbe accadere che il suo valore non sia stato ancora aggiornato con le modifiche di A. Con la parola chiave volatile si forza il Thread A a rendere visibili gli aggiornamenti fatti immediatamente.
Ora proviamo a vedere un esempio.


public class Singleton{private static volatile Singleton _instance;
public static Singleton getInstance(){
   if(_instance == null){
            synchronized(Singleton.class){              

              if(_instance == null)
                  _instance = new Singleton();
            }
   }
   return _instance;
}


Se non rendiamo la variabile _instance volatile allora il Thread che sta creando l'istanza di "SIngleton", non è in grado di comunicare a gli altri Thread che l'istanza è stata creata fino a che non finirà l'esecuzione del blocco singleton; quindi se il A sta creando un istanza di Singleton e appena dopo la creazione perde la CPU allora tutti gli altri Thread non saranno in grado di vedere il valore della variabile _instance come non nullo e crederanno che il suo valore sia ancora null.
Infine da ricordare che la parola chiave volatile è valida solo per le variabili. Questa differenzia la parola chiave volatile dalla parola chiave synchronized. 

venerdì 15 giugno 2012

Java ecologico: le variabili d'ambiente e il CLASSPATH


Quando si parla di compilazione di codice Java sicuramente vi sarà capitato di sentir parlare di variabili d'ambiente e CLASSPATH. Il classpath si riferisce al percorso sul tuo file system dove i tuo file .class sono salvati. Il classpath è definito dalla variabile d'ambiente CLASSPATH. Il CLASSPATH specifica le directory e i file JAR dove il compilatore e la JVM troveranno il bytecode. Attraverso l'utilizzo del CLASSPATH si permette di memorizzare il bytecode in directory a nostra scelta o in archivi Java (JAR File).

Rendi ecologico il tuo pc con le variabili d'ambiente..


Per esempio supponiamo di avere la classe com.bustapaga.Impiegato. Il compilatore e la JVM cercheranno la directory \com\bustapaga basandosi sulla variabile d'ambiente CLASSPATH. Quindi se per esempio il file Impiegato.class si trova nella directory

c:\Documents and Settings\Alex\workspaces\build\com\bustapaga

allora la variabile CLASSPATH deve includere la directory

c:\Documents and Settings\Alex\workspaces\build

La variabile CLASSPATH può contenere un qualsiasi numero di directory e file JAR.

Ma come settare questa variabile d'ambiente? Dipende ovviamente dal sistema operativo.

Sotto un sistema Windows: aprire il prompt dei comandi e settare la variabile classpath con questa istruzione (separando i multi valori con il punto e virgola)

set CLASSPATH=”c:\Documents and Settings\Alex\workspaces\build”;
c:\myproject\build;c:\tomcat\lib\servlet.jar;.;

Sotto un sitema Unix: usare il comando setenv per separare valori multipli

setenv CLASSPATH /usr/build:/myproject/build:/tomcat/lib/servlet.jar

Attenzione! Un errore comune da evitare è quello di includere parte del nome del percorso del package nella variabile CLASSPATH. Da evitare ad esempio un errore simile:

set CLASSPATH=c:\myproject\build\com\bustapaga;

mercoledì 13 giugno 2012

Che tipi! Primitive Types vs. Reference Types


Le applicazioni Java prevedono due tipi di dati: primitivi e referenziati. I tipi primitivi sono i classici tipi di dati che si imparano sin dalle prime lezioni di programmazione e sono riassunti nella tabella qui sotto.


La tabella mostra anche i diversi range di valori permessi per ogni tipo. Difficile ricordare ogni singolo range mentre può essere molto utile ricordare la dimensione in bits prevista per ogni tipo.

Un Reference type invece, sono variabili che sono tipi di classe, tipi di interfacce o tipi di array. Una "reference" fa riferimento a un oggeto (un istanza di una classe). A differenza dei tipi primitivi che mantengono i loro valori im memoria dove la variabile è allocata, le referenze non mantengono il valore dell'oggetto a cui si riferiscono. Una referenza "punta" ad un oggetto memorizzando l'indirizzo dove l'oggetto è collocato. Tutto questo può essere ricondotto al conetto di "puntatore". Tuttavia Java non permette al programmatore di accedere direttamente ad un indirizzo fisico di memoria. Quindi anche se le referenze sono simili ai puntatori, è possibile solo usare una referenza per accedere ad un campo o un metodo dell'oggetto a cui fa riferimento. Risulta impossibile quindi determinare il reale indirizzo di memoria della variabile referenziata.
Vediamo un esempio ora. Dichiariamo due referenze:

java.util.Date today;
String greeting;

La variabile today è una refernza di tipo Date e può puntare solo a un oggetto di tipo Date. La variabile greeting invece è una referenza che può puntare solo ad un oggetto di tipo String. Un valore può essere assegnato ad una referenza in due modi:
- Una referenza può essere assegnata ad una referenza dello stesso tipo
- Una referenza può essere assegnata ad un nuovo oggetto usando la parola chiave "new"

Ad esempio assegnamo le due precedenti referenze a due nuovi oggetti:

today = new java.util.Date();
greeting = “How are you?”;

Ecco come queste due referenze sono rappresentate in memoria:

martedì 24 aprile 2012

Il plurale di Http? Https!

Ecco un'altra classica domanda che ti capita, cosi per caso, ad un colloquio di lavoro. Che differenza c'è tra http e https? Diamo per scontato che sappiamo di cosa parliamo (protocolli) e che già siamo al corrente dell'esistenza del protocollo http. Che differenza c'è con il protocollo Https? la differenza la fa la S finale che sta per "secure". Si, il protocollo https è un'evoluzione di Http per renderlo più sicuro. In particolare è una combinazione del protocollo Http e il protocollo SSL/TLS. Il problema principale del protocollo Http è la possibilità di subire attacchi del tipo Man in the middle (un tipo di attacco dove l'attaccante è in grado di intercettare le comunicazioni tra i due partecipanti).


Https agisce sempre al livello più alto del modello ISO/OSI. Tutti i dati sono criptati compresi gli header. Un webserver per accettare connessioni di tipo Https deve creare un certificato digitale una sorta di carta di identità che associa l'identità di una persona ad una chiave pubblica. Una volta che il sito web ha fornito questo certificato che prova la sua bontà, il protocollo SSL/TLS è più che sufficiente a criptare il canale di comunicazione tra utente e sito web. I certificati sono approvati da specifiche certificate authorities (ad esempio VeriSign/Microsoft/etc.).

mercoledì 8 febbraio 2012

Interview question: Repository Pattern e Factory Pattern

Oggi parleremo di Repository Pattern e Factory Pattern. Entrambi fanno parte della categoria dei Design pattern ossia quell'insieme di schemi di progettazione che permettono di risolvere problemi riccorrenti. Esistono diversi tipi di pattern che sono classificati in base a diversi criteri. Solitamente si sceglie di classificare i pattern a seconda del problema che trattano.
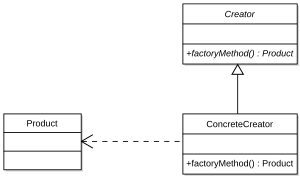
In questo post tratteremo due pattern in particolare: il Factory Pattern e il Repository Pattern. Il Factory Pattern rientra nella categoria dei "pattern creazionali" ossia tutti quei pattern che si nascondono i costruttori delle classi "camuffandoli" con metodi in modo che si possano utilizzare gli oggetti senza sapere come siano utilizzati (un po' come fanno le interfacce). Questo pattern aiuta a modellare un interfaccia per la creazione di un oggetto il quale nel momento in cui viene creato può permettere alle sue sottoclassi di decidere quale classe instanziare.


Questo pattern, come mostrato in figura, è usato quando la classe Creato non conosce in anticipo tutte le sue sottoclassi che andrà a creare. Invce è lasciata ad ogni sottoclasse, la ConcreteCreator, la responsabilità della creazione dell'istanza dell'oggetto corrente.

Il Repository Pattern fa parte dell'insieme dei pattern architetturali che non operano a livello di design e quindi non sono considerati veri e propri pattern. Questo pattern vuole evitare l'accesso diretto alle fonti dati come database, servizi web, liste sharepoint ecc. in quanto questo comperterebbe diversi problemi come codice duplicato, alto rischio di errori di programmazione, tipizzazione debole dei dati di business e cosi via. Cosa propone questo pattern? L'utilizzo di un repository per separare la logica di ritrovamento dei dati dalla logica di bussiness.


In questo modo la logica di bussiness e il data source non comunicano direttamente ma lo fanno solo attraverso i repository come mostrato in precedenza nella figura.


martedì 22 novembre 2011

Interview question: differenza tra architettura a 2 tier e achitettura a 3 tier

Partiamo col dire che quando si parla di tier la ment va subito a un'applicazione di tipo client-server. Per spiegare la differenza tra queste due architetture partiamo da un esempio.

Supponiamo di voler scrivere un programma che permetta in una scuola agli studenti di sapere la media dei voti nelle diverse materie. Il programma è strutturato in modo che i voti degli alunni siano memorizzati nel database che risiede sul server, mentre l'applicazione che permette di accedere ai voti e alla media risiede lato client. Quando gli studenti vogliono sapere la media dei loro voti utilizzano il programma (cliccando sui pulsanti, aprendo le fineste ecc.) inviando cosi una query al database che risiede sul server. Il database risponderà con i dati richiesti e l'applicazione calcolerà cosi la media. 
Questo è un esempio di architettura a 2 tier. I 2 tier sono:
  1. Data server, dove girà il database contenente le informazioni
  2. L'applicazione client
Questa architettura va bene se la scuola avesse solo una cinquantina di studenti. Ma supponiamo che la scuola abbia 10000 studenti. Ora la situazione inizia a farsi più problematica...
Ogni volta che uno studente, attraverso l'applicazione client, effettua una query il data server dovrà gestire questa query. Questo diventa un enorme lavoro per una risorsa di rete.
Per ovviare a tale problema si utilizza l'architettura a 3 tier, inserendo un altro programma a livello server, chiamato server application. In questo modo l'applicazione client non farà più riferimento al database ma passerà prima attraverso l'application server che poi girerà le queries al database.
Ora ogni studente per sapere la sua media dovrà eseguire i seguenti passi:
  1. Lo studente interroga l'applicazione client
  2. L'applicazione client interroga l'applicazione server
  3. L'applicazione server effettua la query sul data server
  4. Il data server restituisce un recordset contenente i voti dello studente
  5. L'applicazione server effettuerà tutti i calcoli per determinare la media
  6. L'applicazione server restituisce la media calcolata all'applicazione client
  7. L'applicazione client mostra la media allo studente
Anche se il processo sembra più lungo su carta, in realtà è molto più veloce. Questo perchè al paso 6 all'applicazione client non viene più resitutito un recordset (che generà un grande ammontare di traffico di rete) ma solo un semplice numero!


Ovviamente esistono altri vantaggi di un'architettura a 3 tier ma in questo articolo ho solo voluto dare un'idea generale sulle 2 architetture.


Questo articolo prende spunto principalmente da link


mercoledì 16 novembre 2011

Interview question: SOLID

Questo è il primo di una lunga serie di post dove parleremo di possibili domande a cui un informatico potrebbe andare incontro.

  • Cos'è SOLID?
SOLID sta per Single responsibility, Open-closed, Liskov substitution, Interface segregation and Dependency inversion. Il termine è stato introdotto per la prima volta da Robert C. Martin agli inizi dell'anno 2000 per indicare un nuovo principio di programmazione e design object-oriented. Quando è applicato il principio permette di avere un sistema facile da manutenere e da estendere col tempo. Andiamo ad analizzare ogni singolo concetto di questo nuovo principio.

  • Single responsibility principle (SRP)
Ogni oggetto dovrebbe avere un sola singola responsabilità. In pratica ogni classe dovrebbe concentrarsi sul fare una sola cosa.

  • Open/closed principle (OCP)
Le entità software dovrebbero essere aperte per l'estensioni ma chiuse per le modifiche. Supponiamo di avere la classe OrderValidation con il metodo Validate (Order order) che contiene tutte le regole per validare un'ordine. Se tali regole cambiano siamo costretti a modificare la classe violando il principio OCP. Se avessimo invece l'oggetto IValidationRule contenente tutte le regole, allora potremmo basare il metodo Validate su questo oggetto e nel caso di cambio di regole basterà creare un nuovo IValidationRule e passarlo all'istanza di OrderValidation al run time.

  • Liskov substitution principle (LSP)
Gli oggetti in un programma dovrebbe essere rimpiazzati con instanze del loro sottotipo senza alterare la correttezza del programma. In pratica le sottoclassi dovrebbero comportarsi correttamente quando usate al posto delle loro classi base.


  • Interface segregation principle (ISP)
Diverse interfacce client specifiche sono meglio di una interfaccia con scopo generale. In pratica mantenere le interfacce piccole e coese.


  • Dependency inversion principle (DIP)
Dipendere dall'astrazione, non dipendere dalle concrezioni. Il metodo di Dependency injection è un modo per seguire questo principio. Tale metodo è un design pattern per la programmazione orientata agli oggetti per cui una classe o un sistema non è responsabile circa l'inizializzazione delle proprie dipendenze. Per maggiore informazioni dare un'occhiata su questo blog.


Per maggiori approfondimenti consultare il seguente link.